Спеціаліст з обробки даних · Спортивна аналітика · Валенсія

Перетворюю дані на чіткі рішення

Я є містком між аналізом даних та елітним спортом: перетворюю показники ефективності на стратегії, які роблять різницю на полі.

  • Python
  • R
  • SQL
  • Power BI
  • Machine Learning
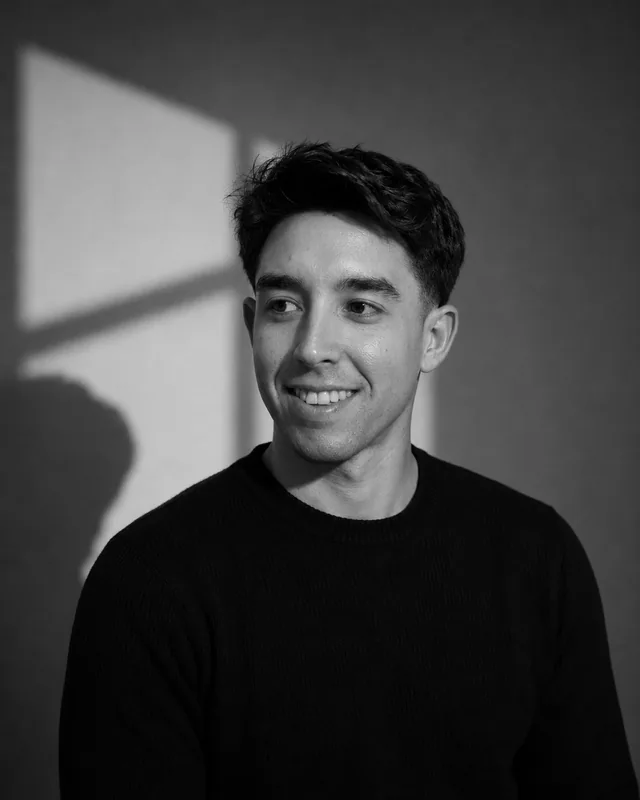
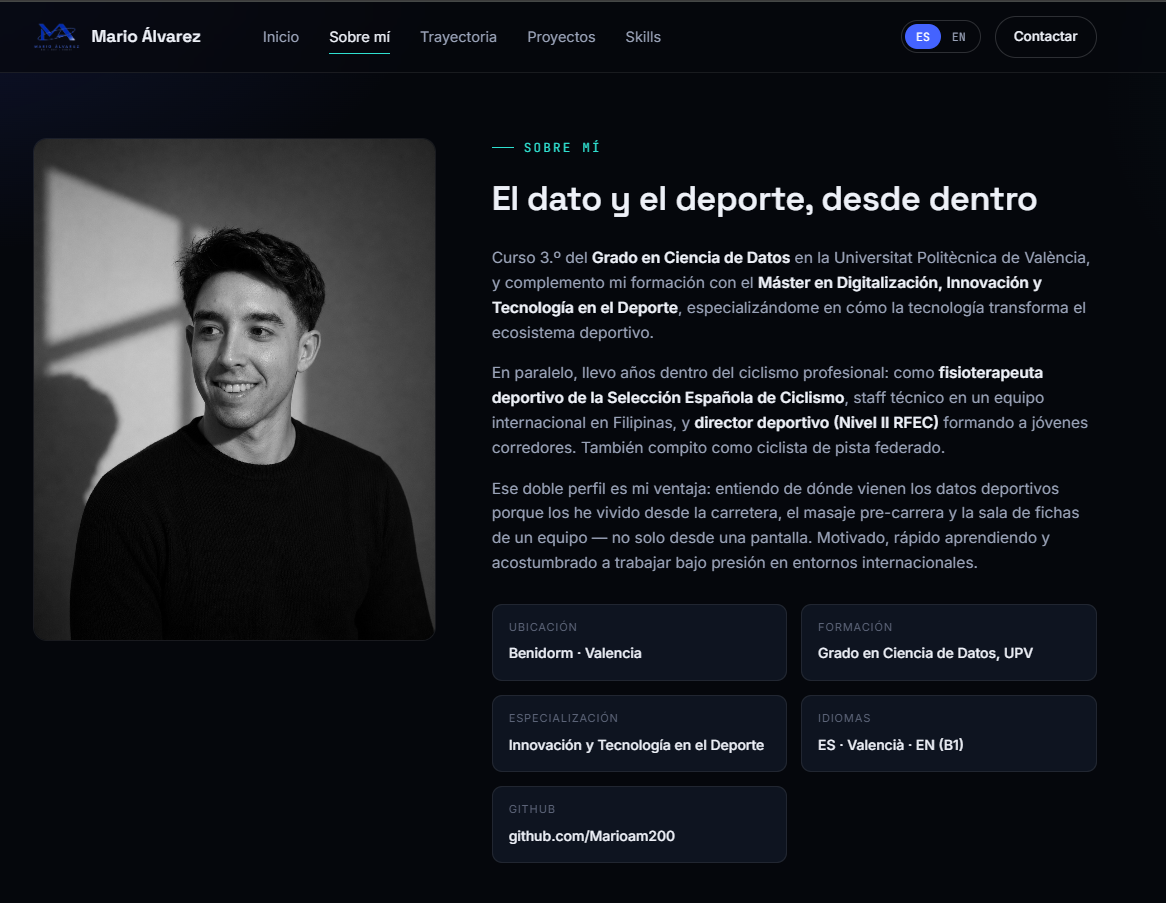
Retrato de Mario Álvarez

Про мене

Дані в контексті траси, дороги та змагань

Я Маріо Альварес, студент спеціальності «Наука про дані» в UPV з реальним досвідом у професійному велоспорті. Я поєдную аналіз даних зі спортивними результатами елітного рівня, щоб перетворити кожен показник на рішення, яке покращує результати.

Дивитися більше

UPV

Освіта

Ступінь бакалавра з науки про дані, Політехнічний університет Валенсії.

Еліта

Досвід

Реальна робота в команді професійного велоспорту.

Data + Sport

Підхід

Аналітика, застосована для покращення спортивних результатів.

Досвід

Два світи, одна мова: результативність

Я змагався на найвищому рівні і сьогодні застосовую цей же критерій до даних: я розумію, що означає число для спортсмена, тому що я був цим спортсменом.

Дивитися більше

Робота

Проєкти

Автоматична підбірка моїх публічних репозиторіїв на GitHub.

Спеціалізації

  • HTML
  • Power BI
  • Python
  • R
  • SQL

VIS

HTML

This repository contains coursework, practical exercises, and study materials for a university data visualization course. It includes solved programming tasks using R and Python libraries like ggplot2 and Plotly, alongside practice dashboards built in Tableau.

Дивитися на GitHub
EVALUACION-DE-MODELOS-

HTML

This repository contains practical assignments for a university model evaluation course, covering topics such as cost-sensitive classification, fairness metrics on the COMPAS dataset, and model interpretability using partial dependence plots. The exercises and analyses are implemented using Python and R across Jupyter Notebooks and R Markdown reports.

Дивитися на GitHub

TRABAJO_MDP

An academic data analysis project in R that explores and characterizes a physicochemical crystal dataset. It covers data cleaning, preprocessing, and dimensionality reduction through Principal Component Analysis (PCA) using packages such as FactoMineR, factoextra, and ggplot2.

Дивитися на GitHub

TRABAJO_CORREDORES

Python

A Streamlit web application that helps manage cycling teams by scraping race and rider data from ProCyclingStats and FirstCycling to analyze upcoming events and cyclist specialties. It is built with Python using BeautifulSoup, Selenium, Pandas, and the Gemini API to process data and extract UCI points regulations from PDFs.

Дивитися на GitHub

COFIDIS

Python

Developed as an academic project, this tool scrapes UCI rankings and race data from ProCyclingStats to calculate race difficulty scores tailored to the Cofidis cycling team's calendar. It is built with Python, using Selenium and BeautifulSoup for web scraping, Pandas for data processing, and Streamlit for the interactive interface.

Дивитися на GitHub
Переглянути всі проєкти

Поговоримо про дані?

Розкажіть про свій проєкт, і ми разом знайдемо рішення, які покращують результати.

Перейти до контактів