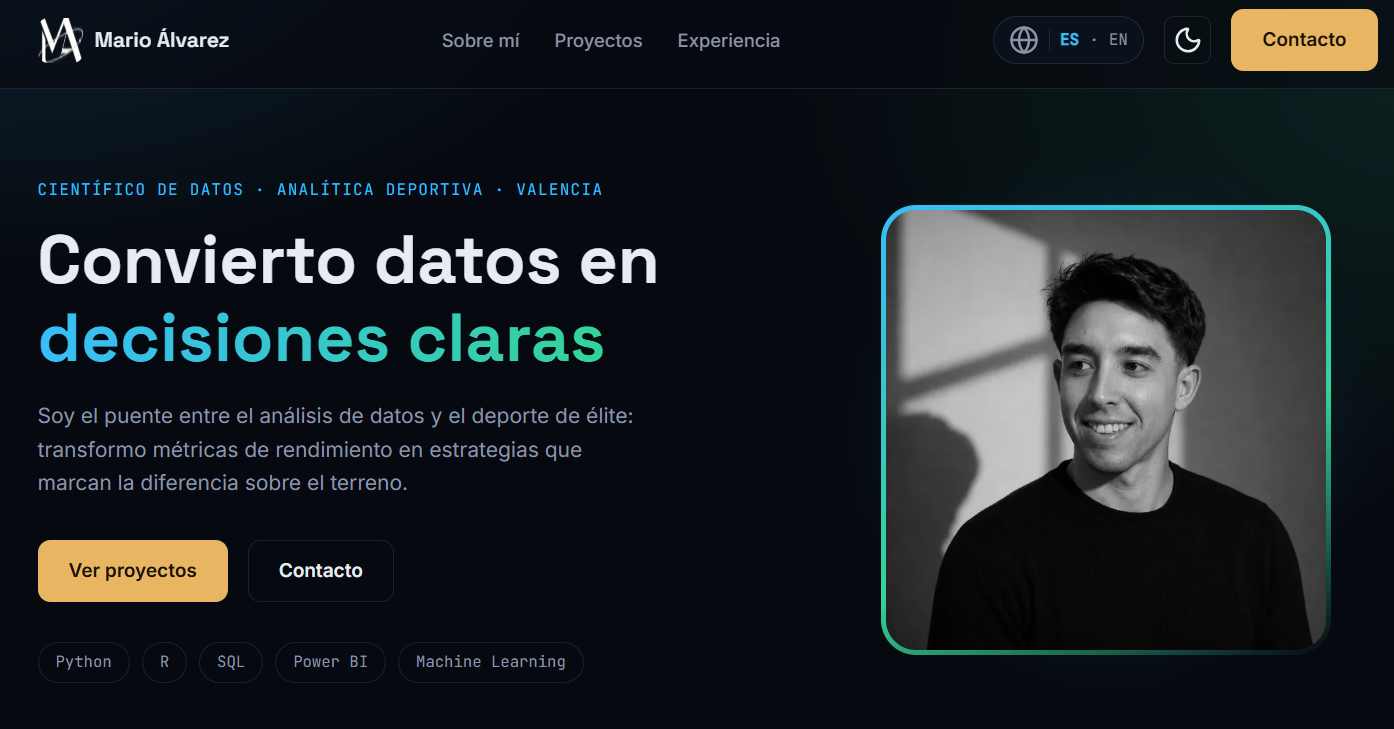
Analityk danych · Analityka sportowa · Walencja

Zamieniam dane w jasne decyzje

Jestem pomostem między analizą danych a sportem wyczynowym: przekształcam metryki wydajności w strategie, które robią różnicę na boisku.

  • Python
  • R
  • SQL
  • Power BI
  • Machine Learning
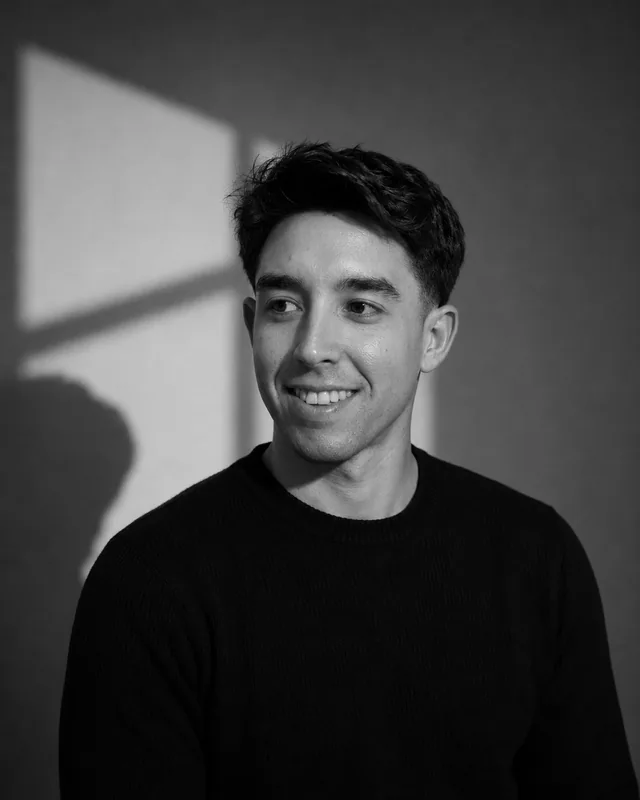
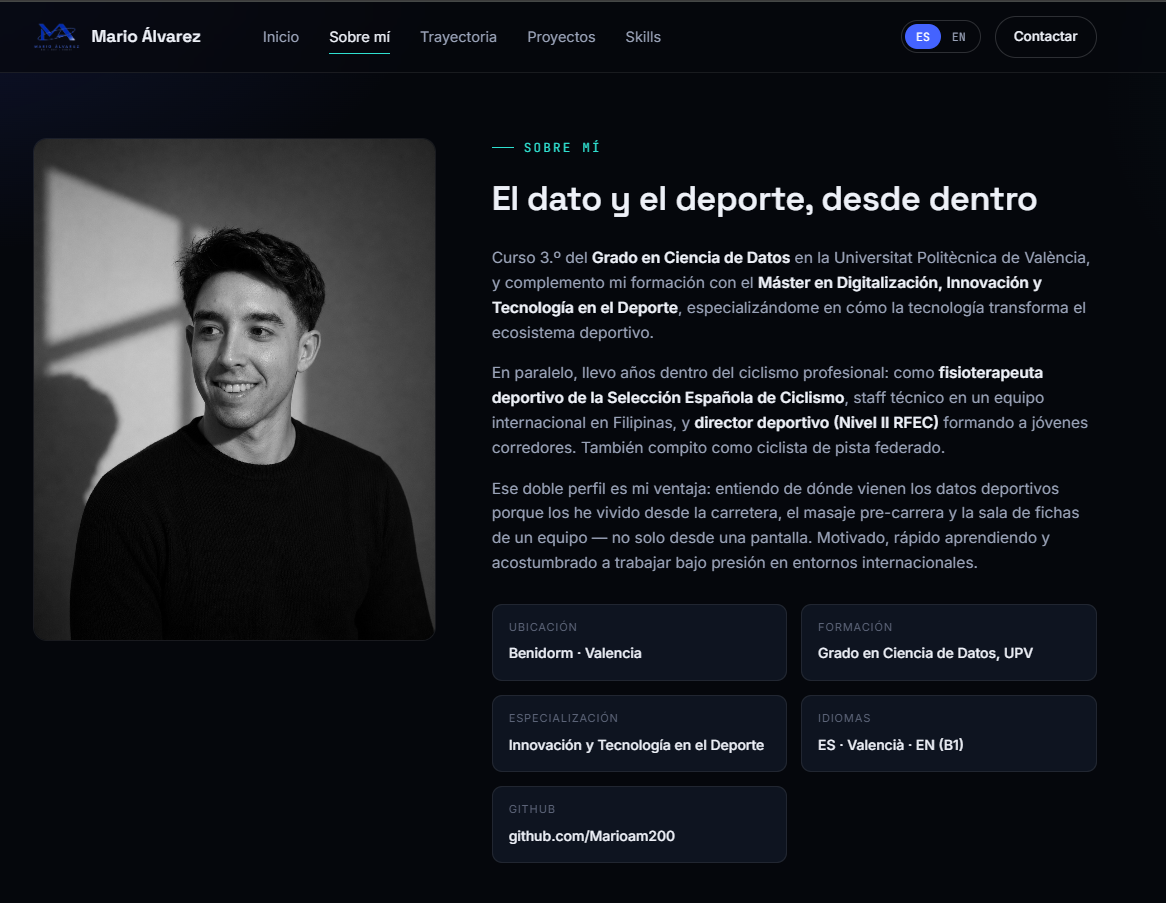
Retrato de Mario Álvarez

O mnie

Dane z kontekstem toru, szosy i rywalizacji

Nazywam się Mario Álvarez, jestem studentem Data Science na UPV z rzeczywistym doświadczeniem w kolarstwie zawodowym. Łączę analizę danych z wynikami sportowymi na najwyższym poziomie, aby przekształcić każdą metrykę w decyzję poprawiającą wyniki.

Zobacz więcej

UPV

Wykształcenie

Studia licencjackie z Data Science, Universitat Politècnica de València.

Elita

Doświadczenie

Rzeczywista praca w zawodowej grupie kolarskiej.

Data + Sport

Podejście

Analityka stosowana do poprawy wyników sportowych.

Doświadczenie

Dwa światy, ten sam język: wyniki

Rywalizowałem na najwyższym poziomie, a dzisiaj stosuję te same kryteria do danych: rozumiem, co liczba oznacza dla sportońca, ponieważ sam nim byłem.

Zobacz więcej

Praca

Projekty

Automatyczny wybór moich publicznych repozytoriów na GitHubie.

Specjalizacje

  • HTML
  • Power BI
  • Python
  • R
  • SQL

VIS

HTML

This repository contains coursework, practical exercises, and study materials for a university data visualization course. It includes solved programming tasks using R and Python libraries like ggplot2 and Plotly, alongside practice dashboards built in Tableau.

Zobacz na GitHub
EVALUACION-DE-MODELOS-

HTML

This repository contains practical assignments for a university model evaluation course, covering topics such as cost-sensitive classification, fairness metrics on the COMPAS dataset, and model interpretability using partial dependence plots. The exercises and analyses are implemented using Python and R across Jupyter Notebooks and R Markdown reports.

Zobacz na GitHub

TRABAJO_MDP

An academic data analysis project in R that explores and characterizes a physicochemical crystal dataset. It covers data cleaning, preprocessing, and dimensionality reduction through Principal Component Analysis (PCA) using packages such as FactoMineR, factoextra, and ggplot2.

Zobacz na GitHub

TRABAJO_CORREDORES

Python

A Streamlit web application that helps manage cycling teams by scraping race and rider data from ProCyclingStats and FirstCycling to analyze upcoming events and cyclist specialties. It is built with Python using BeautifulSoup, Selenium, Pandas, and the Gemini API to process data and extract UCI points regulations from PDFs.

Zobacz na GitHub

COFIDIS

Python

Developed as an academic project, this tool scrapes UCI rankings and race data from ProCyclingStats to calculate race difficulty scores tailored to the Cofidis cycling team's calendar. It is built with Python, using Selenium and BeautifulSoup for web scraping, Pandas for data processing, and Streamlit for the interactive interface.

Zobacz na GitHub
Zobacz wszystkie projekty

Porozmawiajmy o danych?

Opowiedz mi o swoim projekcie i poszukajmy razem miejsc na decyzje, które poprawiają wyniki.

Przejdź do kontaktu