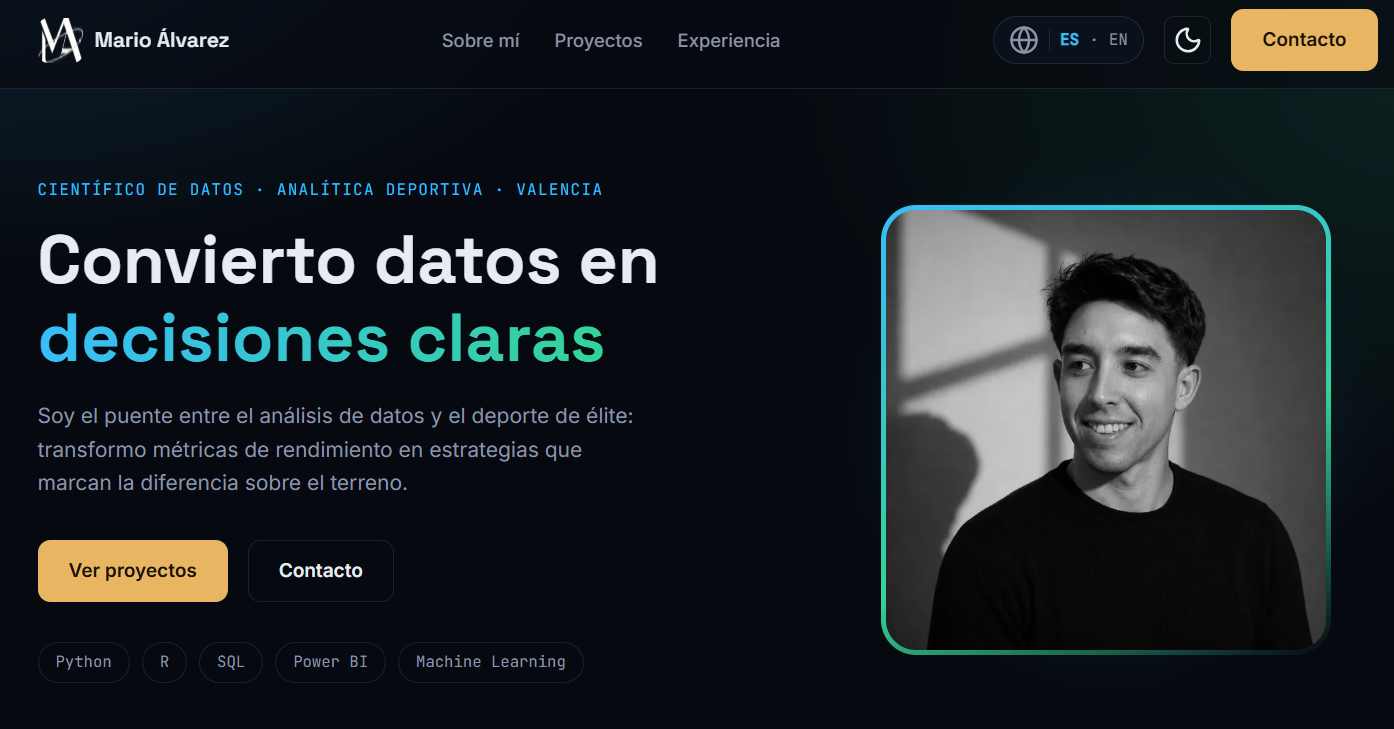
Data scientist · Analytique sportive · Valencia

Je transforme les données en décisions claires

Je suis le pont entre l'analyse des données et le sport de haut niveau : je transforme les mesures de performance en stratégies qui font la différence sur le terrain.

  • Python
  • R
  • SQL
  • Power BI
  • Machine Learning
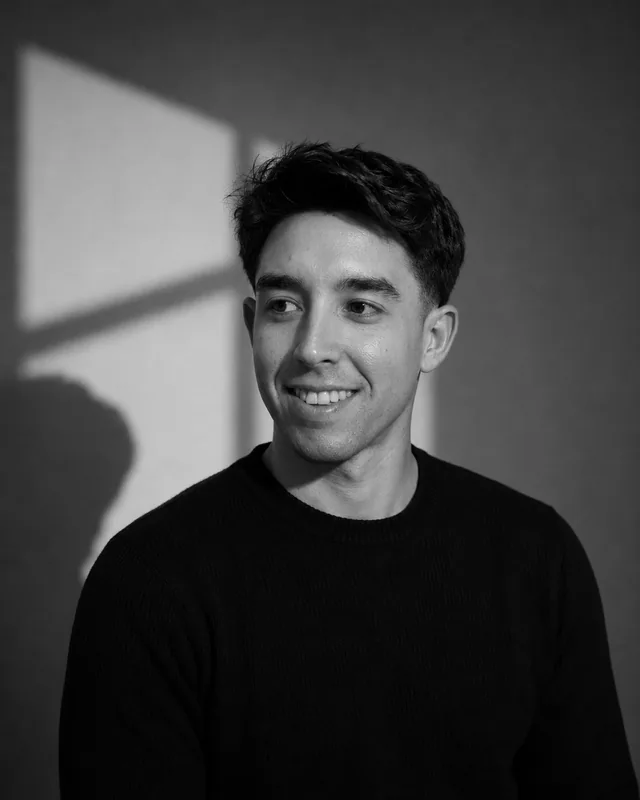
Retrato de Mario Álvarez

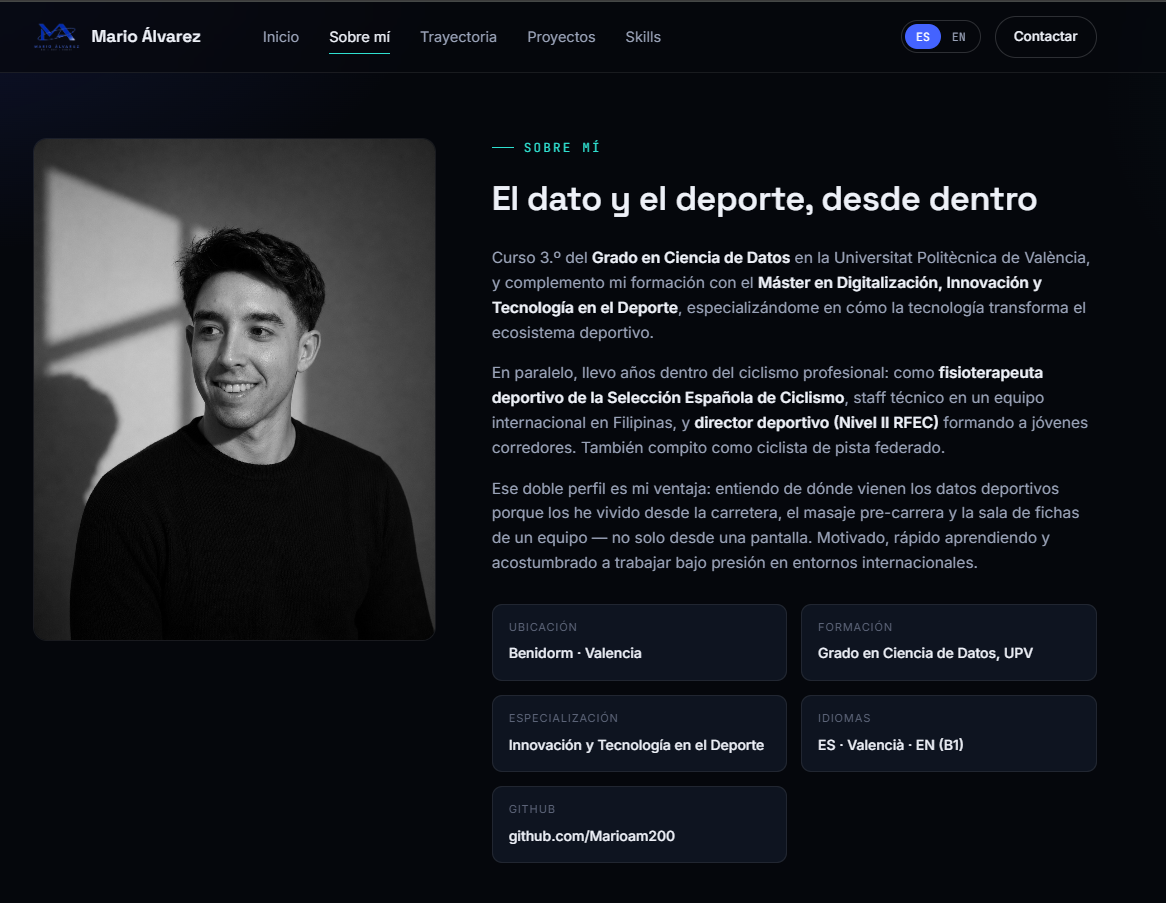
À propos de moi

Des données avec un contexte de piste, de route et de compétition

Je suis Mario Álvarez, étudiant en science des données à l'UPV avec une expérience réelle dans le cyclisme professionnel. Je combine l'analyse des données et la performance sportive d'élite pour transformer chaque métrique en une décision qui améliore les résultats.

Voir plus

UPV

Formation

Licence en Science des Données, Universitat Politècnica de València.

Élite

Expérience

Travail réel au sein d'une équipe cycliste professionnelle.

Data + Sport

Approche

Analytique appliquée à l'amélioration de la performance sportive.

Expérience

Deux mondes, un même langage : la performance

J'ai concouru au plus haut niveau et aujourd'hui j'applique ce même critère aux données : je comprends ce qu'un chiffre signifie pour un sportif parce que j'ai été ce sportif.

Voir plus

Travail

Projets

Une sélection automatique de mes dépôts publics sur GitHub.

Spécialisations

  • HTML
  • Power BI
  • Python
  • R
  • SQL

VIS

HTML

This repository contains coursework, practical exercises, and study materials for a university data visualization course. It includes solved programming tasks using R and Python libraries like ggplot2 and Plotly, alongside practice dashboards built in Tableau.

Voir sur GitHub

EVALUACION-DE-MODELOS-

HTML

This repository contains practical assignments for a university model evaluation course, covering topics such as cost-sensitive classification, fairness metrics on the COMPAS dataset, and model interpretability using partial dependence plots. The exercises and analyses are implemented using Python and R across Jupyter Notebooks and R Markdown reports.

Voir sur GitHub

TRABAJO_MDP

An academic data analysis project in R that explores and characterizes a physicochemical crystal dataset. It covers data cleaning, preprocessing, and dimensionality reduction through Principal Component Analysis (PCA) using packages such as FactoMineR, factoextra, and ggplot2.

Voir sur GitHub

TRABAJO_CORREDORES

Python

A Streamlit web application that helps manage cycling teams by scraping race and rider data from ProCyclingStats and FirstCycling to analyze upcoming events and cyclist specialties. It is built with Python using BeautifulSoup, Selenium, Pandas, and the Gemini API to process data and extract UCI points regulations from PDFs.

Voir sur GitHub

COFIDIS

Python

Developed as an academic project, this tool scrapes UCI rankings and race data from ProCyclingStats to calculate race difficulty scores tailored to the Cofidis cycling team's calendar. It is built with Python, using Selenium and BeautifulSoup for web scraping, Pandas for data processing, and Streamlit for the interactive interface.

Voir sur GitHub
Voir tous les projets

On parle de données ?

Parlez-moi de votre projet et nous chercherons ensemble où se trouvent les décisions qui améliorent la performance.

Aller au contact