Cientista de dados · Analítica desportiva · Valência

Transformo dados em decisões claras

Sou a ponte entre a análise de dados e o desporto de elite: transformo métricas de rendimento em estratégias que fazem a diferença no terreno.

  • Python
  • R
  • SQL
  • Power BI
  • Machine Learning
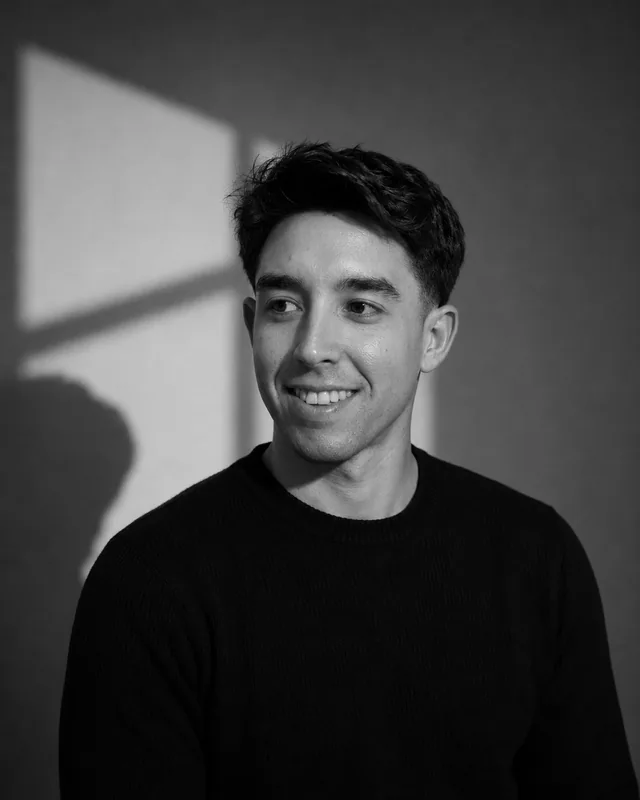
Retrato de Mario Álvarez

Sobre mim

Dados com contexto de pista, estrada e competição

Sou Mario Álvarez, estudante de Ciência de Dados na UPV com experiência real no ciclismo profissional. Combino a análise de dados com o rendimento desportivo de elite, para transformar cada métrica numa decisão que melhora resultados.

Ver mais

UPV

Formação

Licenciatura em Ciência de Dados, Universitat Politècnica de València.

Elite

Experiência

Trabalho real numa equipa de ciclismo profissional.

Data + Sport

Abordagem

Analítica aplicada à melhoria do rendimento desportivo.

Experiência

Dois mundos, um mesmo idioma: o rendimento

Competi ao mais alto nível e hoje aplico esse mesmo critério aos dados: percebo o que um número significa para um desportista porque já fui esse desportista.

Ver mais

Trabalho

Projetos

Uma seleção automática dos meus repositórios públicos no GitHub.

Especializações

  • HTML
  • Power BI
  • Python
  • R
  • SQL

VIS

HTML

This repository contains coursework, practical exercises, and study materials for a university data visualization course. It includes solved programming tasks using R and Python libraries like ggplot2 and Plotly, alongside practice dashboards built in Tableau.

Ver no GitHub
EVALUACION-DE-MODELOS-

HTML

This repository contains practical assignments for a university model evaluation course, covering topics such as cost-sensitive classification, fairness metrics on the COMPAS dataset, and model interpretability using partial dependence plots. The exercises and analyses are implemented using Python and R across Jupyter Notebooks and R Markdown reports.

Ver no GitHub

TRABAJO_MDP

An academic data analysis project in R that explores and characterizes a physicochemical crystal dataset. It covers data cleaning, preprocessing, and dimensionality reduction through Principal Component Analysis (PCA) using packages such as FactoMineR, factoextra, and ggplot2.

Ver no GitHub

TRABAJO_CORREDORES

Python

A Streamlit web application that helps manage cycling teams by scraping race and rider data from ProCyclingStats and FirstCycling to analyze upcoming events and cyclist specialties. It is built with Python using BeautifulSoup, Selenium, Pandas, and the Gemini API to process data and extract UCI points regulations from PDFs.

Ver no GitHub

COFIDIS

Python

Developed as an academic project, this tool scrapes UCI rankings and race data from ProCyclingStats to calculate race difficulty scores tailored to the Cofidis cycling team's calendar. It is built with Python, using Selenium and BeautifulSoup for web scraping, Pandas for data processing, and Streamlit for the interactive interface.

Ver no GitHub

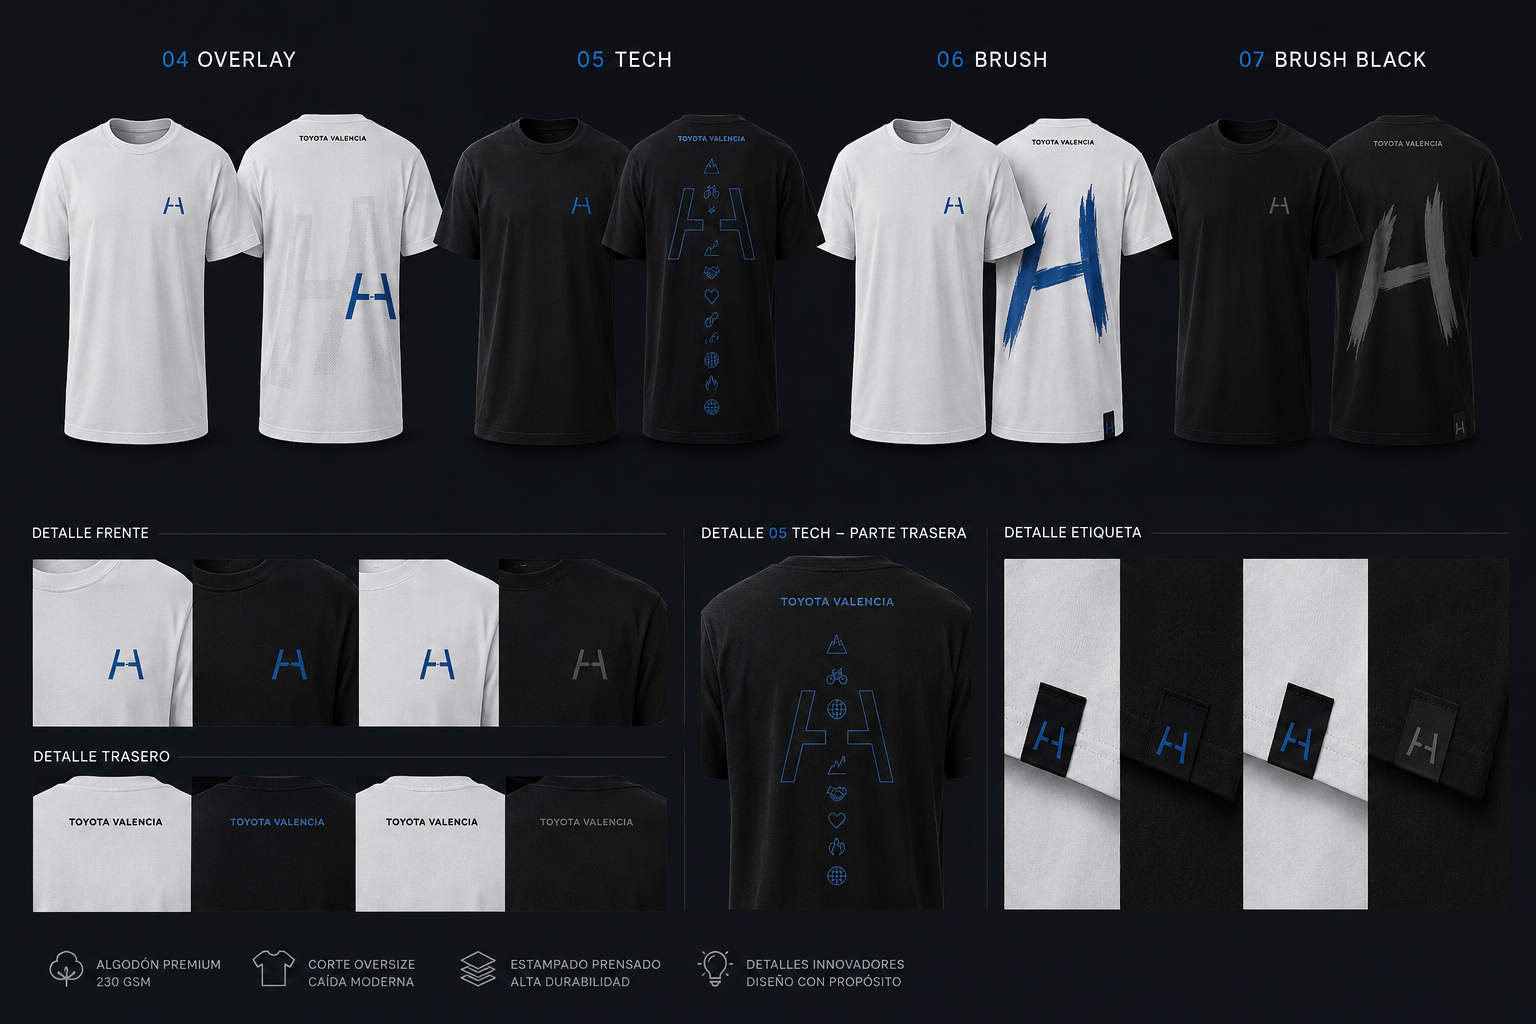
CATALOGO_ROPA-_CICLISTA

Catalog of Héctor Álvarez's first clothing collection

Ver todos os projetos

Falamos de dados?

Conta-me o teu projeto e procuramos juntos onde estão as decisões que melhoram o rendimento.

Ir para contacto