Mtaalamu wa takwimu · Uchambuzi wa michezo · Valencia

Ninageuza data kuwa maamuzi yaliyo wazi

Mimi ni daraja kati ya uchambuzi wa data na michezo ya kiwango cha juu: ninageuza vipimo vya utendakazi kuwa mikakati inayofanya tofauti uwanjani.

  • Python
  • R
  • SQL
  • Power BI
  • Machine Learning
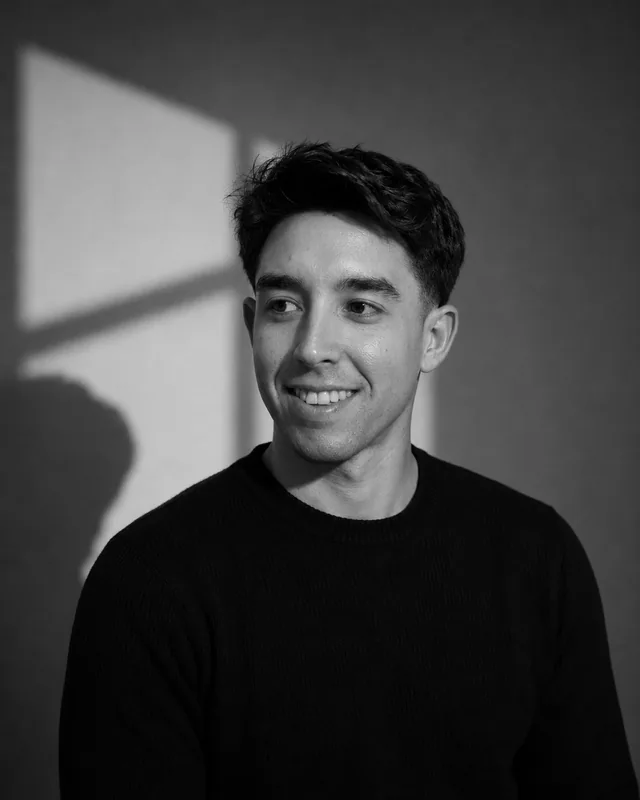
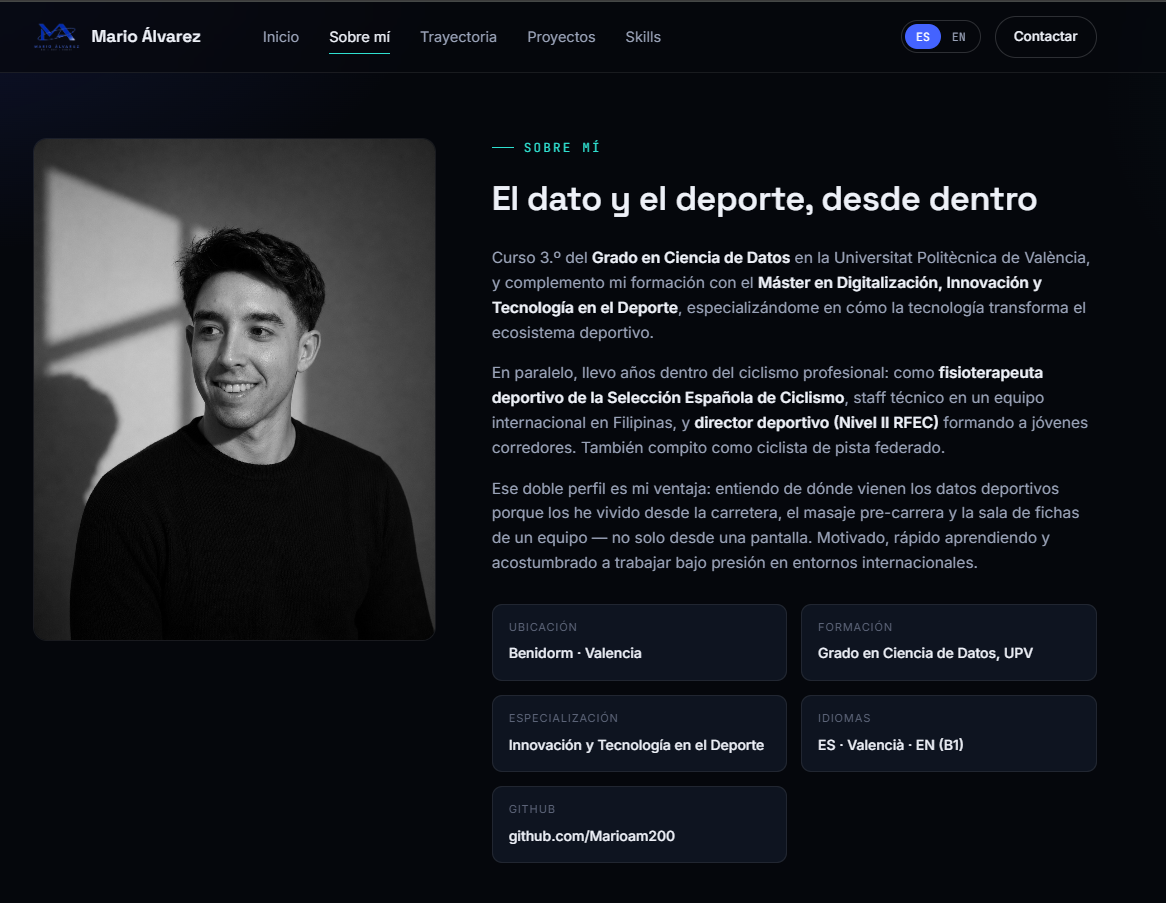
Retrato de Mario Álvarez

Kuhusu mimi

Data yenye muktadha wa uwanja, barabara na mashindano

Mimi ni Mario Álvarez, mwanafunzi wa Sayansi ya Data katika UPV mwenye uzoefu halisi ndani ya timu ya kitaalamu ya baiskeli. Ninachanganya uchambuzi wa data na utendakazi wa michezo ya kiwango cha juu, ili kugeuza kila kipimo kuwa uamuzi unaoboresha matokeo.

Tazama zaidi

UPV

Elimu

Shahada ya Sayansi ya Data, Universitat Politècnica de València.

Kiwango cha juu

Uzoefu

Kazi halisi ndani ya timu ya kitaalamu ya baiskeli.

Data + Sport

Mtazamo

Uchambuzi uliotumika kuboresha utendakazi wa michezo.

Uzoefu

Dunia mbili, lugha moja: utendakazi

Nimeshindana katika kiwango cha juu zaidi na leo ninatumia kigezo hicho hicho kwa data: ninaelewa namba inamaanisha nini kwa mwanamichezo kwa sababu nimekuwa mwanamichezo huyo.

Tazama zaidi

Kazi

Miradi

Uteuzi wa kiotomatiki wa hazina zangu za umma kwenye GitHub.

Utaalamu

  • HTML
  • Power BI
  • Python
  • R
  • SQL

VIS

HTML

This repository contains coursework, practical exercises, and study materials for a university data visualization course. It includes solved programming tasks using R and Python libraries like ggplot2 and Plotly, alongside practice dashboards built in Tableau.

Tazama kwenye GitHub
EVALUACION-DE-MODELOS-

HTML

This repository contains practical assignments for a university model evaluation course, covering topics such as cost-sensitive classification, fairness metrics on the COMPAS dataset, and model interpretability using partial dependence plots. The exercises and analyses are implemented using Python and R across Jupyter Notebooks and R Markdown reports.

Tazama kwenye GitHub

TRABAJO_MDP

An academic data analysis project in R that explores and characterizes a physicochemical crystal dataset. It covers data cleaning, preprocessing, and dimensionality reduction through Principal Component Analysis (PCA) using packages such as FactoMineR, factoextra, and ggplot2.

Tazama kwenye GitHub

TRABAJO_CORREDORES

Python

A Streamlit web application that helps manage cycling teams by scraping race and rider data from ProCyclingStats and FirstCycling to analyze upcoming events and cyclist specialties. It is built with Python using BeautifulSoup, Selenium, Pandas, and the Gemini API to process data and extract UCI points regulations from PDFs.

Tazama kwenye GitHub

COFIDIS

Python

Developed as an academic project, this tool scrapes UCI rankings and race data from ProCyclingStats to calculate race difficulty scores tailored to the Cofidis cycling team's calendar. It is built with Python, using Selenium and BeautifulSoup for web scraping, Pandas for data processing, and Streamlit for the interactive interface.

Tazama kwenye GitHub
Tazama miradi yote

Tuzungumze kuhusu data?

Niambie kuhusu mradi wako na tutatafuta pamoja mahali ambapo kuna maamuzi yanayoboresha utendakazi.

Nenda kwenye mawasiliano